
Webshop terheléses teszt k6-tal: így írj valós forgatókönyvet éles indulás előtt
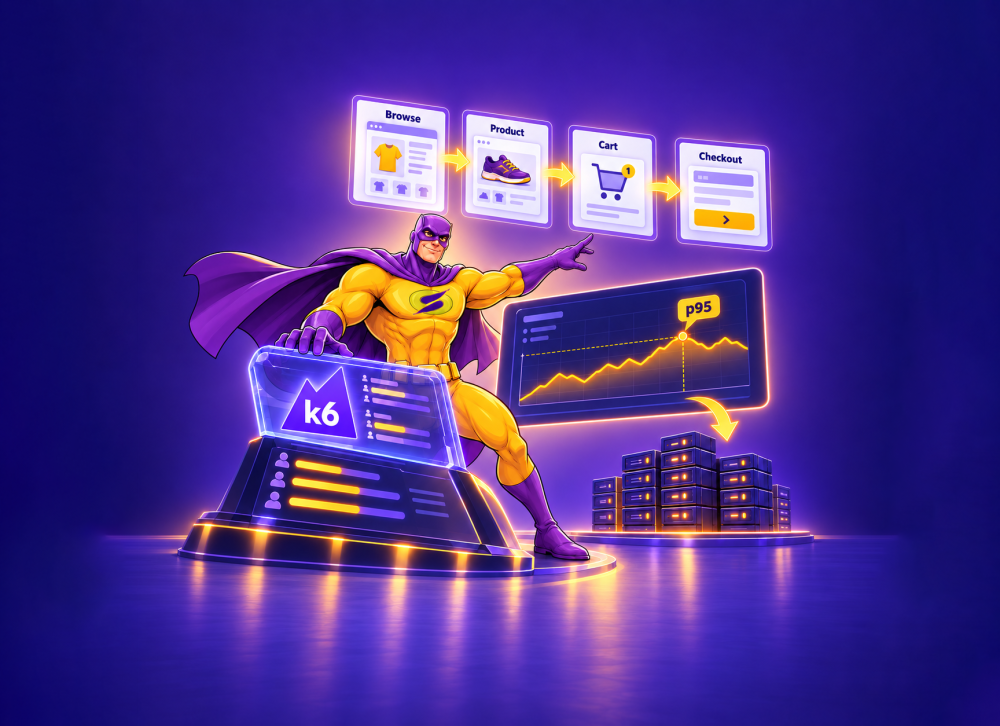
A terheléses teszt akkor ér valamit, ha nemcsak azt mutatja meg, hogy a kezdőlap válaszol-e, hanem azt is, hogy a webshop végigviszi-e a vásárlót a termékoldaltól a pénztárig, amikor egyszerre sokan érkeznek.
A kampány előtti kérdés ezért nem az, hogy hány URL-t tudsz meghívni percenként. A valódi kérdés az, hogy a böngészés, a kosár, a készletkezelés és a checkout együtt hogyan viselkedik, miközben a forgalom fokozatosan nő.
Ebben az útmutatóban egy használható k6-forgatókönyvet építünk fel: meghatározzuk a vásárlói útvonalat, különválasztjuk a ramp-up futásokat, kijelöljük a p95- és hibaarány-méréseket, majd az eredményeket szerverkapacitási döntéssé fordítjuk le.
Hogyan épül fel a valós webshop-terheléses teszt k6-tal?
A valós webshop-forgatókönyv egymásra épülő vásárlói lépések sorozata, nem egyetlen URL ismételt meghívása. A k6-tal ezért a böngészés, a kosárba helyezés és a pénztár külön szakaszait érdemes modellezni, majd egy közös flow-ban összekapcsolni.
A k6 egy JavaScript-alapú, fejlesztőknek készült terhelés- és teljesítménytesztelő eszköz, amellyel virtuális felhasználókat, HTTP-kéréseket és üzleti folyamatokat szimulálhatsz. A k6 mérőszámokat, küszöbértékeket és fokozatos terhelési profilokat kezel, ezért automatizált tesztfolyamatba is beilleszthető.
A kezdőlap vagy egy cache-elt kategóriaoldal önmagában túl optimista képet adhat. A webshop teljesítményét gyakran a keresés, a szűrés, a kosárfrissítés vagy a fizetési folyamat terheli meg, ezért ezeket nem szabad kihagyni.
Böngészési forgatókönyv
A böngészési szakasz útvonala például: kampány landing page vagy nyitóoldal → kategóriaoldal → szűrés vagy keresés → termékoldal → további termékmegnyitás. A teszt ne mindig ugyanazt a terméket kérje le: használj több kategóriát és véletlenszerűen választott termékazonosítókat, hogy a cache és az adatbázis ne egyetlen URL-re optimalizálja a képet.
A sleep() hívásokkal adj rövid gondolkodási időt a virtuális felhasználóknak. Egy 100 milliszekundumos, folyamatos kérésáradat inkább API-roham, mint vásárlói forgalom; a néhány másodperces szünetekkel felépített útvonal közelebb áll egy valódi kampányhoz.
Kosárba tevési forgatókönyv
A kosárszakaszban a felhasználó valóban helyezzen terméket a kosárba, majd ellenőrizd, hogy a kosár válasza üzletileg is helyes-e. A 200-as HTTP-kód önmagában kevés: a terméknek, a mennyiségnek, az árnak és az esetleges kuponnak is meg kell jelennie a várt állapotban.
Egy kuponos termékbevezetésre készülő, 300 SKU-s WooCommerce-webshopnál például más terhelést jelent 12 különböző termék véletlenszerű kosárba helyezése, mint ugyanazt az egy akciós SKU-t ismételni minden iterációban. A tesztadatokat úgy válaszd meg, hogy a készlet- és kuponlogika is életszerű legyen, de a futás után tisztítható maradjon.
Pénztárforgatókönyv
A checkout a webshop legérzékenyebb pontja, ezért önálló mérési egységként kezeld. A flow tartalmazza a szállítási adatokat, a szállítási módot, a fizetési módot, a rendelés-összesítést és a fizetési szolgáltató sandbox-válaszát.
A session- és tokenkezelést ugyanúgy ellenőrizd, mint a válaszidőt. A siker feltétele például az, hogy a tesztvásárló rendelése létrejön, a rendelési állapot a várt értéket kapja, és a készletmozgás nem hagy maga után olyan adatot, amely a következő futást torzítja. Valódi fizetést ne indíts; a sandbox a checkout-logika terhelés alatti vizsgálatára való.
A kód szerkezetét érdemes üzleti lépések szerint csoportosítani és tagelni. A group() a riportban egységbe rendezi az egyes lépéseket, a kérésekhez adott flow tag pedig lehetővé teszi, hogy flow-nként küszöbértéket állíts be:
import http from 'k6/http';
import { group, sleep } from 'k6';

const BASE_URL = 'https://pelda-webshop.hu';

export default function () {
  group('browse', () => {
    http.get(`${BASE_URL}/termek-kategoria/cipok/`, {
      tags: { flow: 'browse' },
    });
    sleep(3);
  });

  group('cart', () => {
    http.post(`${BASE_URL}/?wc-ajax=add_to_cart`, cartPayload, {
      tags: { flow: 'cart' },
    });
    sleep(2);
  });

  group('checkout', () => {
    http.post(`${BASE_URL}/?wc-ajax=checkout`, checkoutPayload, {
      tags: { flow: 'checkout' },
    });
  });
}
A példában szereplő URL-ek, a cartPayload és a checkoutPayload helyére a saját végpontjaid, tokenjeid és tesztadataid kerülnek. Egy valódi flow-ban lépésenként több kérés is fut, ezért mindegyikhez add hozzá ugyanazt a flow taget. A group() önmagában nem hoz létre flow taget: a csoport neve a group tagbe kerül ::checkout formában, így ha csoportra írnál küszöbértéket, a {group:::checkout} szűrőt kell használnod. Így a k6 riportjában külön látod, melyik flow kezdett lassulni.
A tesztadatokhoz készíts külön mátrixot: melyik termék, kategória, kupon, szállítási mód és fizetési sandbox-válasz szerepel az adott futásban. Rögzítsd a WordPress- és WooCommerce-verziót, a bővítmények állapotát, a cache-beállításokat és a szerver aktuális konfigurációját is. Ha a peak futás után módosítasz valamit, az ismételt mérés csak akkor összehasonlítható, ha ezeket a változásokat feljegyzed.
Milyen ramp-up profillal emeld a terhelést?
A jó ramp-up profil fokozatosan építi fel a forgalmat, és külön választja a működés ellenőrzését, a normál terhelés mérését, a várt csúcsot és a töréspont keresését. Egyetlen, hirtelen indított csúcstesztből nehéz megmondani, mikor és miért romlott a webshop teljesítménye.
A négy egymásra épülő futás legyen a következő:
- Smoke test: 1–2 virtuális felhasználóval ellenőrizd a teljes útvonalat. A session, a kosár, a checkout-token és a sandbox-fizetés hibamentesen fusson végig.
- Baseline futás: modellezd a megszokott napi terhelést 10–15 percig. Ez lesz az összehasonlítási alap a kampány előtti és utáni futásokhoz.
- Peak futás: fokozatosan érd el a kampány vagy az éles indulás becsült maximumát, majd tartsd ezen a szinten elég ideig ahhoz, hogy a cache, a PHP workerek és az adatbázis terhelése beálljon.
- Stress futás: kontrolláltan lépj a várt csúcs fölé. A cél a lassulás és a töréspont mintázatának megfigyelése, nem a rendszer felügyelet nélküli túlterhelése.
A k6-ban két eltérő logika közül választhatsz:
| Executor | Mit szabályoz? | Mikor válaszd? |
|---|---|---|
ramping-vus |
Az egyidejűleg aktív virtuális felhasználók számát | Ha azt akarod látni, hogyan viselkedik a webshop adott számú párhuzamos vásárlónál |
ramping-arrival-rate |
Az időegység alatt induló iterációk számát | Ha a kérdésed a beérkező forgalom ütemére vonatkozik, például kampány vagy launch előtt |
A ramping-vus zárt modell: minden virtuális felhasználó végigfuttatja a saját iterációját, és csak utána kezd újat. Ha a webshop lassul, a VU-k tovább várnak egy-egy válaszra, így percenként kevesebb iteráció indul, és a terhelés magától csökken. Ez jól mutatja a párhuzamos felhasználók hatását, de egy kampányroham valódi ütemét alábecsülheti, mert a valódi vásárlók nem várják meg, amíg a többiek végeznek.
A ramping-arrival-rate nyílt modellként az iterációk indítási ütemét szabályozza, nem azt feltételezi, hogy minden felhasználó ugyanabban a ciklusban mozog. Itt a preAllocatedVUs kulcsfontosságú: ha kevés VU áll rendelkezésre, a terhelésgenerátor nem tudja tartani a kívánt érkezési ütemet. A 150 iteráció percenként ezért nem azonos 150 egyidejű látogatóval, mert egy iteráció több HTTP-kérést és eltérő hosszúságú checkoutot tartalmazhat.
Kezdésnek használhatsz egy 45 perces keretet: 5 perc bemelegítés, 10 perc fokozatos emelés, 15 perc a várt csúcson, 10 perc kontrollált túlterhelés, majd 5 perc levezetés. A célértékeket a saját forgalmi adataidból és a baseline futásból vedd, ne általános internetes példákból. A futások között ne ürítsd ki automatikusan az összes mérési előzményt: a baseline, a peak és a stress eredménye kerüljön ugyanabba a riportba, ugyanazokkal a flow-tagekkel. Így látszik, hogy a lassulás fokozatos volt-e, vagy csak egy hibás tesztadat okozta.
Mit mérj a terheléses tesztben: p95, hibaarány és erőforrások?
Egy terheléses teszt akkor használható, ha nemcsak az átlagos válaszidőt nézed, hanem a lassabb kéréseket, a hibás kéréseket és a szerveroldali erőforrásokat is ugyanahhoz a futáshoz kötöd. A válaszidő megmutatja, mit érez a vásárló, a monitoring pedig segít megérteni, miért alakult úgy az eredmény.
A p95 válaszidő azt mutatja meg, hogy a kérések 95 százaléka milyen időn belül fejeződik be. A p95 azért hasznosabb az átlagnál, mert nem rejti el a lassabb, még mindig tömegesen előforduló kéréseket, amelyek egy kampány alatt már érezhetően rontják a vásárlói élményt.
A minimum mérési készlet
A k6 riportjában legalább ezeket kövesd:
http_req_duration: átlag mellett p95 és p99, lehetőleg flow-nként bontva;http_req_failed: a hibás HTTP-kérések aránya;checks: üzleti ellenőrzések, például bekerült-e a termék a kosárba vagy létrejött-e a rendelés;iterationséshttp_reqs: a végrehajtott folyamatok és kérések mennyisége;dropped_iterations: az el nem indított iterációk száma, amely arrival-rate futásnál VU- vagy rendszerlimitre is utalhat.
A küszöbértékeket a baseline-hoz és az üzleti elváráshoz igazítsd. Az alábbi csak minta: az 1 százalék alatti hibaarány és a checkout 1200 ms alatti p95-je nem univerzális igazság, hanem egy olyan ellenőrzés, amelyet a saját üzleti folyamatodhoz kell kalibrálni.
export const options = {
  thresholds: {
    http_req_failed: ['rate<0.01'],
    'http_req_duration{flow:checkout}': ['p(95)<1200'],
  },
};
A flow:browse, flow:cart és flow:checkout tagek lehetővé teszik, hogy ne egyetlen összesített számból próbáld kitalálni, mi romlott el. Ha az átlag jó, de a checkout p95-je meredeken nő, a kampány szempontjából a lassú pénztár a fontos jel. A p99-et se hagyd figyelmen kívül: néhány nagyon lassú kérés nem mindig változtatja meg látványosan a p95-öt, mégis hibás külső API-hívásra vagy időszakos adatbázis-zárra hívhatja fel a figyelmet.
Szerveroldali mérőszámok
A k6 mellé gyűjts CPU- és memóriahasználatot, lemez-I/O-t, IOPS-ot, adatbázis-kapcsolatszámot, PHP worker-terhelést, cache hit/miss arányt és hálózati forgalmat. A tárhely erőforrás-felhasználásának vizsgálatáról szóló útmutató segít abban, hogy a k6 görbéit ne önmagukban olvasd.
Képzeld el úgy, hogy a k6 megmutatja, mit érez a vásárló az ajtón keresztül: mennyit vár a kasszánál. A szervermonitoring azt mutatja meg, mi történik odabent a raktárban és a kasszánál: elfogy-e a PHP worker, sorban állnak-e az adatbázis-kapcsolatok, vagy a háttértár dolgozik a határán.
Hogyan fordítsd le a mérési eredményt szerverkapacitásra?
A mérésből akkor lesz kapacitásdöntés, ha a p95 válaszidőt, a hibaarányt, a dropped_iterations értékét és az erőforrásgörbéket együtt olvasod. Egyetlen lassú futás még nem bizonyít infrastruktúralimitet; az ismételhető mintázat és a terhelési szinthez kötött változás már igen erős jel.
Négy tipikus mintázat
- Magas p95 és magas CPU- vagy PHP worker-terhelés: alkalmazásoldali, PHP- vagy webszerveres szűk keresztmetszetre utal. Előbb a lassú végpontokat és a párhuzamos feldolgozást vizsgáld.
- Magas p95 és magas adatbázis- vagy I/O-terhelés: lekérdezési, indexelési vagy háttértár-probléma valószínű. A checkout és a keresés különösen gyakran hozza elő ezt a mintát.
- Növekvő hibaarány alacsony szerverterhelés mellett: külső API, fizetési sandbox, sessionkezelés vagy alkalmazáslogika lehet a hibaforrás. Ilyenkor a nagyobb szerver önmagában nem biztos, hogy megoldja a problémát.
- Növekvő
dropped_iterationsérték: először ellenőrizd apreAllocatedVUsértékét és a terhelésgenerátor erőforrásait. Ha a válaszidő romlásával együtt nő, a rendszer lassulása is hozzájárulhat; ha már a futás elején megjelenik, a k6-környezet lehet alulméretezett.
A döntéshez hasonlítsd össze a baseline-, peak- és stress-futás azonos flow-jait. Jegyezd fel azt a terhelési szintet, ahol a p95 tartósan romlik, majd futtasd újra a tesztet a javítás után. Így nem érzésre választasz szerverkörnyezetet, hanem megmutatható, hogy a változtatás melyik mérőszámot javította. A riportban külön jelöld a terhelésgenerátor, a webshop és a külső szolgáltatások állapotát. Ez a bontás megakadályozza, hogy egy hálózati vagy fizetési sandbox-problémát tévesen szerverkapacitás-hiányként kezelj.
Mikor indokolt VPS vagy dedikált szerver?
VPS akkor kerül elő, amikor a webshopnak a megosztott környezetnél jobban kontrollálható, elkülönített erőforrásokra van szüksége, és a kapacitást a teszt eredményei alapján szeretnéd tovább méretezni. A Sybell Hosting Prémium AMD virtuális szerverei (EPIC Titan VPS5 és EPIC Titan VPS10) 4. generációs AMD EPYC processzoron, DDR5 5600 MHz-es memórián és NVMe U.3 SSD-s RAID10 tárolón futnak. A gyors memória és háttértár pont ott ad tartalékot, ahol a terheléses teszt a legtöbbször szűk keresztmetszetet mutat: a checkout és a keresés adatbázis- és I/O-terhelésénél.
Dedikált szerver akkor indokolt, ha tartósan nagy a terhelés, speciális konfigurációra van szükséged, vagy teljes fizikai gépet állítanál a webshop mögé. A Sybell Hosting dedikált szerverei IPMI IP KVM konzollal távolról is teljes hozzáférést adnak a géphez. A redundáns tápegység és a hot-swap meghajtóhelyek az üzembiztonságot szolgálják, az opcionális hardveres RAID és a 10 Gbit/s-os hálózati kártya pedig nagy forgalomnál is tartalékot ad.
Ha a mérés a szerverváltás irányába mutat, de nem szeretnéd saját csapatodra venni az üzemeltetési terheket, a Sybell Hosting menedzselt szervere lehet a következő vizsgálandó irány. A kapacitásváltás előtt azonban mindig különítsd el az alkalmazás-, adatbázis- és infrastruktúrahibát; így nem drágább környezetben próbálsz megoldani egy hibás checkout-flow-t.
Gyakori kérdések
Kell valódi fizetést futtatni a checkout terheléses tesztjéhez?
Nem, a checkout terheléses teszt sandbox fizetési környezettel is felépíthető. A cél a sessionkezelés, a pénztárlogika és a rendelésfolyamat terhelés alatti vizsgálata, nem valódi tranzakciók indítása.
Honnan futtassam a k6-ot, hogy a terhelésgenerátor ne torzítsa a mérést?
A k6-ot külön gépről vagy felhőkörnyezetből futtasd, amely nem ugyanazokat a CPU-, memória- és hálózati erőforrásokat használja, mint a webshop. A terhelésgenerátoron is figyeld a CPU-t, a memóriát és a hálózatot, mert egy saját oldali limit félrevezető eredményt ad.
Futtathatok-e terheléses tesztet éles webshopon?
Igen, de csak kontrollált idősávban, sandbox fizetéssel, tisztítható tesztadatokkal és az üzemeltető előzetes egyeztetésével. Éles rendszeren a terheléses teszt célja a felügyelt mérés, nem a meglepetésszerű forgalomgenerálás.
Hány virtuális felhasználóval induljak?
Először 1–2 virtuális felhasználóval ellenőrizd, hogy a teljes flow stabilan lefut-e. Ezután a baseline futásból és a kampány várható forgalmából számold ki a fokozatos emelés célértékeit.
Mikor érdemes ramping-arrival-rate alapú k6-szcenáriót használni?
Akkor érdemes ezt az executort választani, amikor az üzleti kérdésed a beérkező forgalom üteméhez kötődik, például kampány- vagy launch-helyzetben. A ramping-arrival-rate az időegység alatt indított iterációk számát szabályozza, ezért a preAllocatedVUs értékét is a várható iterációs időhöz kell igazítanod.
Összegzés
A jó terheléses teszt valós vásárlói útvonalat modellez, fokozatosan építi fel a csúcsot, p95-ben és hibaarányban mér, majd az eredményt szerverkapacitási döntéssé alakítja. Ha a baseline és a stress-futás már egyértelműen nagyobb környezetet indokol, ne találgass: a mérési mintázat alapján válassz következő infrastruktúraszintet.
Ha a mérés azt mutatja, hogy a webshopod kinőtte a jelenlegi környezetét, nézd meg a Sybell Hosting Prémium AMD virtuális szervereit és dedikált szervereit.
Prémium virtuális szerver csomagjaink »